Распознавание текста: 9 лучших программ
Возможностей чтения и редактирования материалов в интернете огромное количество. Так как многие файлы распространяются по сети без возможности редактирования, порой приходится использовать специальные программы для распознавания текста.
Я расскажу о 9 наиболее популярных и действенных вариантах, плюс приведу основные преимущества и недостатки каждого приложения.
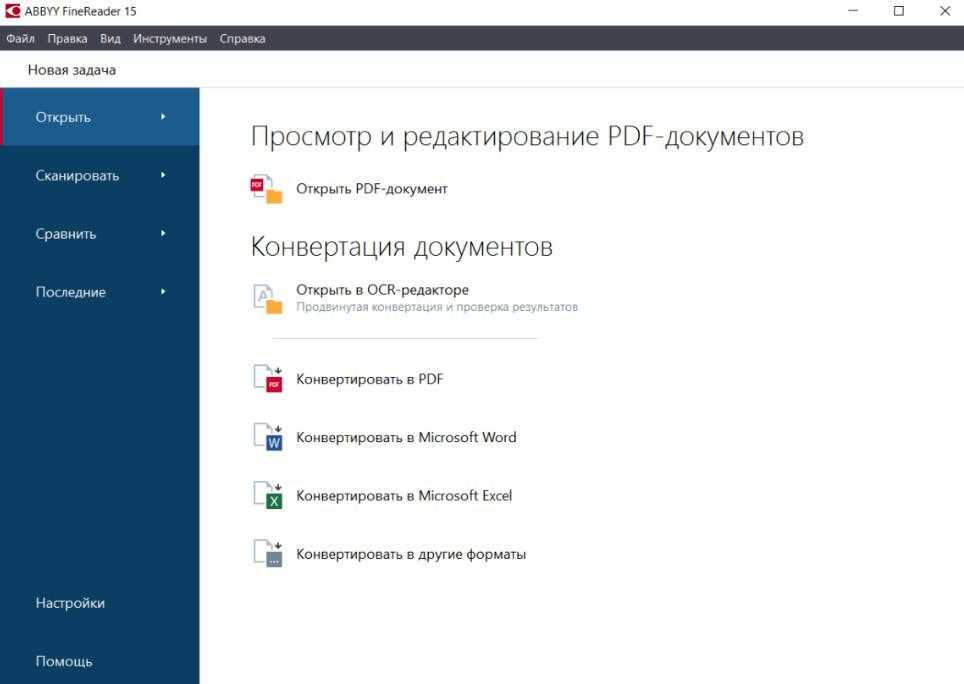
ABBYY FineReader
Программа о сканированию и распознавании текста

Это, пожалуй, самая лучшая программа, которая сканирует и распознает текст с изображений в формате jpg, jpeg, png, gif, bmp, а также pdf документов.
Основные характеристики:
- Работает со 179 языками мира
- Высокая точность распознавания
- Возможность сохранения оформления и стиля
- Интерфейс на русском языке
Версии:
- FineReader
- FineReader Professional
Плюсы:
Программа ABBYY Screenshot Reader

Отличие от FineReader в схеме распознавания. Программа считывает данные с экрана.
- Создание скриншотов
- Распознавание текста с экрана
- Возможность добавления языков
Adobe Acrobat
Программа для работы с pdf

Adobe Acrobat – создание и редактирование pdf документов.
- Доступные версии: Standard, Pro
- Стоимость: 1777 руб/мес (Standard), 1932 руб/мес (Pro)
- 7-дневный пробный период
Эти программы помогут вам эффективно распознавать текст с различных источников и удобно работать с ним в редакторе.
Программы для распознавания текста с картинок
Когда возникает необходимость распознать текст с изображений, можно использовать специальные программы для этого. Рассмотрим некоторые из них:
Freemore OCR
Приложение Freemore OCR позволяет расшифровать текст с файлов форматов jpeg, tiff, bmp, gif, png, wmf, psd, tga и др. Встроенная технология Side-by-Side качественно разделяет картинки и символы. Результат можно сохранить в формате doc, txt или pdf. Есть предварительный просмотр документа, возможность изменения масштабов и прикрепления цифровых подписей.

Kofax OmniPage
Kofax OmniPage – профессиональная программа для распознавания текста с изображений. Конвертирует любой документ в текстовый редактор, с возможностью экспорта в Word. Программа платная, стоимость от 149 долларов.

Microsoft OneNote
Microsoft OneNote – приложение для учета записей с функцией распознавания текста с рисунков на разных языках. Простой способ скопировать текст из изображения. Бесплатная программа включена в пакет Office.

OCR CuneiForm
OCR CuneiForm – бесплатный аналог программы ABBYY FineReader. Прост в использовании, хорошо распознает текст с отсканированных или сфотографированных материалов. Сохраняет исходную структуру и шрифты.

Лучшие программы для распознавания текста на русском языке
Эта утилита отлично сканирует фото и файлы формата jpeg, tiff и так далее, конвертируя полученный материал в Word или любой другой документ из пакета Microsoft Office. Дополнительно в ней возможно проверить редактируемый текст на наличие ошибок. Только поддерживаемых языков не совсем много – в районе 20, но русский входит в их число.
Readiris

Уникальная и очень мощная программа Readiris распознает тексты с помощью сканера или МФУ, также с файлов форматов pdf, djvu, tiff и jpeg. В ней предусмотрена интеллектуальная система распознавания бумажных сканов с рукописными данными. В целом, разборчивый и понятный почерк она отлично распознает, причем на украинском и русском языках.
Всего предусмотрено 3 версии – PDF, Pro и Corporate. Отличаются они по возможностям и стоимости. Самой оптимальной будет вторая версия, так как в ней есть основные компоненты и поддержка практических 138 языков мира.
Scanitto

И последняя программа в нашем обзоре – Scanitto, которая может распознать текст с копий. С ее помощью можно объединить несколько файлов в один формата PDF или TIFF. Интерфейс Scanitto выполнен в виде альтернативного сканера. В нем можно захватывать определенные фрагменты через специальное оборудование, а затем импортировать выделенный материал в редактор.
В редакторе возможно выделять и помечать какие-то элементы, также разворачивать в нужном направлении. Программа распознает около 7 языков, в том числе русский. Готовый материал легко сохранить в формате bmp, jpeg, tiff, png, pdf или даже gif.
На этом, пожалуй, обзор закончен. Выбирайте любую программу для распознавания текста на свое усмотрение, учитывая все возможные плюсы и минусы. Есть, конечно, еще различные онлайн-сервисы, но их надежность и качество сканирования оставляют желать лучшего.
OCR — это технология преобразования файлов, созданных на основе изображений, в редактируемый текст. К файлам, созданным на основе изображений, относятся документы, отсканированные из учебников, журналов или рукописный текст в печатный, обычно сохраняемые в формате PDF. Технология распознавания символов (OCR) позволяет извлечь текст из этих изображений и сделать его редактируемым. В этой статье мы представим 10 лучших бесплатных программ для распознавания текста, которые помогут вам с легкостью редактировать отсканированные PDF-файлы.
Лучших бесплатных программ для распознавания текста
PDFelement оснащен эффективными инструментами редактирования, которые позволяют вставлять, удалять или изменять текст, изображения и страницы. Вы также можете заполнять интерактивные и неинтерактивные формы и создавать новые формы с различными вариантами их заполнения.
Wondershare PDFelement – Интеллектуальные PDF-решения, упрощенные с помощью искусственного интеллекта.
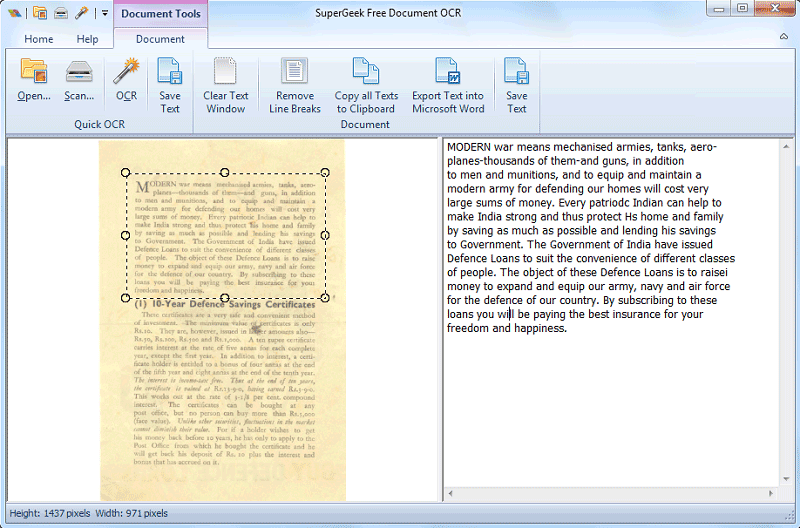
SuperGeek Free Document OCR — бесплатная программа для оптического распознавания символов (OCR), которая поддерживает форматы PDF, TIFF, JPEG, GIF, BMP, PNG, EMF, WMF и TGA. Эта программа позволяет конвертировать изображения с текстом в редактируемые документы в форматах TXT, DOC, PDF или HTML. SuperGeek Free Document OCR имеет простой интерфейс и может распознавать текст на 50 языках.
SmartOCR
SmartOCR является программным обеспечением для распознавания текста, которое может работать с изображениями форматов BMP, JPEG, TIFF, PDF и многими другими. Программа поддерживает более 40 языков и позволяет конвертировать текст из изображений в редактируемые форматы, такие как TXT, DOC, PDF и даже в текст в виде файлов HTML. SmartOCR также поддерживает пакетную обработку изображений и автосканирование.
ABBYY FineReader
ABBYY FineReader – это одно из самых популярных и профессиональных программных средств для распознавания текста и конвертации изображений в редактируемые форматы. Программа поддерживает более 190 языков и имеет высокую точность распознавания. ABBYY FineReader позволяет работать с документами в форматах PDF, JPEG, PNG, TIFF и других. Возможности программы включают автоматическое выравнивание изображений, обработку многостраничных документов, а также распознавание таблиц и графических элементов.
Используйте эти удобные онлайн-инструменты для преобразования стопок бумажных документов в цифровой формат с помощью функций распознавания текста. Это позволит упростить архивирование, редактирование и обмен документами, сэкономив ваше время и ресурсы.
SuperGeek Free Document OCR — удобная и мощная программа для конвертирования изображений и распознавания текста (OCR), подходящая как для профессионального, так и для домашнего использования. Позволяет читать текст из JPG, JPEG, TIF, TIFF, PNG, BMP, PSD, GIF, EMF, WMF, J2K, DCX, PCX, JP2 и т.д. и конвертировать файлы данных типов в редактируемые документы MSWord и TXT всего за несколько кликов.
OnOCR
Программа onOCR справляется с различными отсканированными PDF или файлами изображений независимо от их размера. Free OCR помогает преобразовывать нередактируемые документы в тексты с возможностью копирования и редактирования. Вы можете обрабатывать как крупные, так и мелкие изображения и преобразовывать их в редактируемый текст.

Investintech
Able2Extract от Investintech — это инструмент для работы PDF с возможностью конвертирования отсканированных PDF в один из более чем 10 различных типов редактируемых файлов. С его помощью вы можете преобразовывать файлы практически любого типа в защищенные PDF, просматривать и редактировать PDF и преобразованные файлы, а также извлекать текст из отсканированных документов.

OCRgeek
OCRGeek позволяет вам выполнять распознавать тексты онлайн в пакетном режиме. Вы можете без проблем загружать по несколько файлов одновременно. Процесс распознавания происходит быстро и просто. Загруженные вами документы будут организованы и одновременно преобразованы в формат TXT. Форматы ввода, которые поддерживает OCRgeek: JPG, PNG, TIFF, PDF, DJVU, GIF и BMP.

Безбумажный офис экономит время и денежные средства, но это означает, что большое количество бумажных документов необходимо оцифровывать путем сканирования. Однако вы не можете редактировать или добавлять что-либо к тексту, это вообще не сэкономит времени. Оптическое распознавание символов (OCR) преобразует текст из этих документов или изображения документов, чтобы вы могли работать с ними в цифровом виде. Существует множество программ распознавания текста. Если вы остановились здесь в поисках идеального устройства распознавания текста для сканирования ваших документов? Хорошее решение!
Но обратите внимание, что идеальное программное обеспечение для распознавания текста не должно ограничиваться только сканированием файлов. Вместо этого в нем должны быть другие дополнительные функции для организации документов, преобразования, редактирования, объединения и так далее. Вот почему мы провели глубокое исследование, чтобы предложить вам эти отличные программы распознавания текста для настольных компьютеров. В этом видео мы порекомендуем пять лучших программ, которые помогут конвертировать ваши документы. Давайте учиться!
https://youtube.com/watch?v=EXatpTzkDCY%3Fhl%3Dru%26cc_lang_pref%3Dru%26cc%3D1
Запись текста с фотографии листа или из аудиозаписи в текстовый файл, доступный для редактирования – довольно часто встречающаяся задача при работе в офисах или учёбы. Для распознавания текстов и аудио в платных сервисах и программах сегодня используются такие подходы, как машинное зрение и распознавание речи с использованием глубоких нейронных сетей.
В данной статье я хочу поделиться реализацией приложения, позволяющего пользователю преобразовать и сохранить текстовую информацию из изображения листа или аудио-файла.
Архитектура приложения и используемый стек технологий
Архитектура разрабатываемого приложения приведена на рисунке 1.
Рисунок 1 – Архитектура разрабатываемого приложения
Архитектура на рисунке 1 реализована как клиент-сервер, в парадигме MVC (Model-View-Controller). Все данные разделяются на компоненты трёх видов: модель, представление и контроллер. Такая архитектура позволяет добиться расширяемости, за счёт независимости изменений каждого компонента.
Модуль интерфейса пользователя предназначен для формирования элементов пользовательского интерфейса и вызовов операций обработки данных. Код модуля размещается на сервере и выполняется в браузере пользователя. Пользователь работает с приложением с использованием браузера с поддержкой Java Script, для тестирования клиентской части использовался Google Chrome. В функции для клиентов входят: отображение информации, загрузка на сервер документов, получение результатов с сервера.
Серверные компоненты системы могут функционировать под управлением любого типа операционной системы, разработка и тестирование велась на Windows.
Модуль обработки операций реализует бизнес-логику программной системы. Он обрабатывает запросы пользователей, вызывает операции сервера проведения расчётов и сервера базы данных. Для реализации модуля была выбрана технология Java Servlet.
Для хранения и функционирования модуля обработки операций и модуля интерфейса пользователя был выбран веб сервер Apache Tomcat, обладающий высокой производительностью, гибким функционалом. Кроме того, Apache Tomcat не требует затрат на лицензирование. Взаимодействие между клиентской и серверной частями программной системы осуществляется по протоколу http (браузер на ПК).
Сервер проведения операций обработки изображений и аудио отвечает за задачи, связанные собственно с извлечением текстов из изображений и аудио-записей и их сохранения в текстовый файлы (использованы файлы *.docx). Указанный сервер реализован на языке Python с использованием библиотеки обработки изображений OpenCV и фреймворка TensorFlow.
Для хранения информации программной системы была выбрана система управления базами данных (СУБД) PostgreSQL. Плюсами выбранной СУБД являются отсутствие платы за лицензионное использование и кроссплатформенностью.
После разработки архитектуры были определены интегрированные среды разработки (IDE) компонент сервера и клиентской части. Для сервера проведения расчётов на Python используется PyCharm, для остальных компонент серверной и клиентской части системы – IntelliJ IDEA; обе IDE разработана компанией JetBrains, похожи по функционалу и интерфейсу, являются кроссплатформенными.
Исходный код приложения находится в репозитории, далее раскрою подробнее реализацию основных компонент приложения.
Разработка сервера обработки текстовых и аудио файлов
Для выполнения задачи распознавания текста с изображения используется технология OCR — обнаружение текстового содержимого на изображениях и перевод изображений в закодированный текст, который компьютер может легко понять. Изображение, содержащее текст, сканируется и анализируется, чтобы идентифицировать символы в нем. После идентификации символ преобразуется в машинно‑кодированный текст.
Для целей OCR использовался пакет PyTesseract, являющейся оболочной для Google Tesseract‑OCR Engine. Tesseract использует нейронные сети и двухступенчатый подход к распознаванию. В первый проход происходит распознавание символов. На втором этапе производится заполнение любых символов, которые имеют низкое значение вероятности правильного определения класса, символами, наиболее подходящими по контексту. Этапы выполняются на базе рекуррентной нейронной сети LSTM, наиболее подходящей для обработки естественного языка.
При работе с документом в формате PDF сначала документ извлекается из массива байт, сохраняется как временный файл и читается в память с использованием библиотеки fitz. Статический метод для этой операции приведён ниже.
Затем документ постранично сохраняется в изображения в формате PNG, и с использованием библиотеки pytesseract извлекается текст из каждого изображения, сохраняясь в текстовый файл, созданный с использованием библиотеки docx.
Код методов для выполнения OCR:
Метод создания объекта класса AudioSegment:
Метод разбивки объекта на звуки, разделённые тишиной:
Метод расшифровки и записи текстового файла:
Файлы *.pdf или *.wav поступают на сервер от клиента через модуль обработки операций, в виде массива байт. Для передачи данных на сервере использована технология сокетов. Для хранения настроек сервера и обработки входящих запросов был создан отдельный класс NetworkServer.
Основной файл запуска cvserver.py выглядит следующим образом:
import keyboard from core.clientServer.networkServer import NetworkServer if __name__ == ‘__main__’: server = NetworkServer() port = 10000 server.init(port) server.start() print("Система запущена!") print("Для выхода введите q") keyboard.wait("q") server.stop() server.done() print("Работа завершена")
Код класса NetworkServer:
import socket from threading import Thread from core.clientsManager import ClientsManager from core.clientServer.clientHandler import ClientHandler from core.requests.requestFactory import RequestFactory class NetworkServer(object): def __init__(self): self._socket = None self._continueWork = False self._thread = None self._clientsManager = ClientsManager() self._requestFactory = RequestFactory() def init(self, portNumber): self._socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM) self._socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1) self._socket.settimeout(0.1) self._socket.bind(("127.0.0.1", portNumber)) self._socket.listen(0) def done(self): self.stop() if not (self._socket is None): self._socket.close() self._socket = None def start(self): if not (self._thread is None): self.stop() self._continueWork = True self._thread = Thread(target=self.__work) self._thread.start() def stop(self): if self._thread is None: return self._continueWork = False self._thread.join() self._thread = None def __work(self): while self._continueWork: try: clientSocket, clientAddress = self._socket.accept() client = ClientHandler(self, clientSocket) self.getClientsManager().Add(client) client.run() except socket.timeout: pass except Exception as e: print("Exception occur: " + e.__str__()) raise def getClientsManager(self): return self._clientsManager def getRequestFactory(self): return self._requestFactory
Сервер может работать с несколькими потоками за счёт использования класса Thread(). Для выстраивания очередей используется вспомогательный класс ClientsManager.
Для работы с входящими запросами и отсылкой ответов используется класс ClientHandler.
from threading import Thread from core.requests.requestResponseBuilder import RequestResponseBuilder class ClientHandler(object): RECEIVE_TIMEOUT = 30 def __init__(self, parent, clientSocket): self._parent = parent self._socket = clientSocket self._thread = None def run(self): self._thread = Thread(target=self.__work) self._thread.start() def __work(self): self._socket.settimeout(self.RECEIVE_TIMEOUT) requestCode, requestBody = RequestResponseBuilder.readRequest(self._socket) responseBody = self._parent.getRequestFactory().handle(requestCode, requestBody) RequestResponseBuilder.writeResponse(self._socket, responseBody) self._socket.close() self._parent.getClientsManager().Remove(self)
Вспомогательный класс RequestFactory выполняет адресацию запросов к классам-обработчикам (RecognitionTextHandler и RecognitionSpeechHandler), в зависимости от кода запроса.
В класс RequestResponseBuilder вынесены статические методы работы для «упаковки» и «распаковки» запросов и ответов в массивы байт.
Используемые в RequestFactory классы-обработчики запросов по сути нужны для передачи распакованного запроса и инструментов для обработки в классы-калькуляторы для выполнения собственно обработки изображений и аудио, статические методы из которых приведены в начале раздела.
Код класса – обработчика для распознавания текста:
Код класса – обработчика для распознавания речи:
Опишем структуру базы данных и остальные модули приложения.
Разработка базы данных
Используемая в ходе работы информация храниться в реляционной базе данных. На рисунке 2 приведена ER диаграмма (сущность-связь) спроектированной для системы базы данных.
Рисунок 2 – ER диаграмма базы данных системы
Модель данных, приведённая на рисунке 2, содержит 4 сущности – таблицы базы данных системы. Каждый экземпляр каждой сущности имеет идентификатор ID, представляющий собой уникальную строку символов, задаваемую с использованием текстового представления стандарта UUID.
Структура базы данных имеет две группы сущностей: 1) отвечающих за авторизацию и права пользователей; 2) отвечающих за хранение информации по распознаваемым файлам.
Для создания тестового варианта базы данных использовался код на Python с использованием SQLAlchemy, позволяющий создать структуру и тестовое наполнения базы данных PostgreSQL. Код для генерации теста находится в папке Tools/ DBGenerate проекта на Github.
Дополнительно о техподдержке
 Простые способы улучшить скорость и громкость Интернета
 Простое беспроводное подключение для ноутбуков: подключитесь к Интернету за считанные минуты
 Почему браузер присылает уведомления от сайтов и как отключить спам на android
 Наслаждайтесь бесперебойной потоковой передачей данных по телефону с помощью этого приложения
 Как настроить удаленное управление смартфоном на android с пк
 Раскрываем тайну: почему кабель для зарядки вашего телефона запутывается?
 Горячая линия О’КЕЙ, как написать в службу поддержки | Горячая Линия
 Исправление мерцания google chrome в windows 10